Фарш не провернуть 💝


Channel's geo and language: World, Russian
Category: Technologies


Меня зовут Алёша, строю инфраструктуру для AI продуктов, занимаюсь инференсом LLM, храню веса на DVD.
Всё серьёзно, блять! 🦄
Личка: @superalesha
CV: https://cv.alesha.pro/
Читать полезные статьи: https://alesha.pro

Related channels
Channel's geo and language
World, Russian
Statistics
Posts filter


В DeepSeek Harness есть встроенный браузер в боковой панели. Но он для человеков, модель не умеет пользоваться. Исправляем 💃

Сделал плагин. Теперь агент сам умеет в нём ворочать, читать, кликать, печатать, скроллить, делать скриншоты и тд и тп. 17 тулов 📈

Вчера загонял туда локального Qwen3.8 Flash Next Abliterated чтобы тот повозился где надо. Всё максимально гладко 🍑

Ставится со страницы Plugins: Add plugin, ввести dsh-sidebar-browser-cdp.
НО ЕСТЬ НЮАНС: DSH при этом надо запускать с флагом --remote-debugging-port=9222, и проверял я только на macOS.

https://github.com/alesha-pro/dsh-sidebar-browser

459 0 22 30 10

Video is unavailable for watching
Show in Telegram
В твиттере очередная драма. На сей раз в нашей Local AI тусовке 😡

Есть аккаунт Mia's AI Lab. Рисованная девчуля на аватарке, постит рецепты запуска моделей на DGX Spark. Меньше чем за 4 месяца аккаунт вырос с 200 до 36 тысяч подписчиков. Рецепты рабочие, людям заходило.

Потом народ полез в гит. Оказалось, что в основе нескольких рецептов лежит чужая работа. Чужой квант перевыложен под её аккаунтом, имя автора стоит на хрен пойми где в ридми, считай в конце. Автора первого коммита в README нет вообще.

При этом сама Mia приходит в чужие репозитории и требует ставить ссылку на неё в самый верх README. А тех, кто задаёт вопросы, блокирует.

Параллельно продаёт установки на спарки за $500-2000 и книгу за $100 о том, как расти в X 📈

Я думаю так - Mia это тупо бренд, а женский образ нужен для внимания и денег от сами знаете кого. В технической тусовке женщина всегда вызывала восторги 🍑

Буду дико благодарен, если зайдете в х и прожмёте там еще пару кнопок - сами знаете каких.


Верим?

Интересный тред кстати


Huihui выложили аблитерейтед BF16 веса Qwen3.8-Flash-Next, и я сразу погнал делать EXL3-кванты.

04.05 bpw готовы, запускаю агентную задачу чтобы проверить адекватность, а модель уходит в loop из 7 zaloop 🔫

Первая мысль - ну квант кривой. Проверили всё казалось бы: конвертер, сравнивали с BF16, смотрели движок и семплинг. Ни-че-го.

В итоге нашли в самих исходных весах коэффициент аблитерации около 1.955 💩

Cравнили BF16 от Huihui с оригинальным Qwen и нашли 144 изменённых тензора в 48 слоях. Почти вся правка шла вдоль одного и того же вектора.

Дальше проверили, какую долю этой компоненты вычли из исходных весов. Получилось около 1.955 вместо 1.0. То есть вычли примерно 195.5%: компонента поменяла знак и сохранила около 95.5% исходной амплитуды. Проверка на отдельных экспертах из начала, середины и конца модели дала тот же коэффициент 🍑

При силе 1.0 компонента вдоль выбранного направления вектора обнуляется, что и должно происходить. При 1.955 она переворачивается и сохраняет почти всю исходную амплитуду. То есть правка удаляла направление совсем иначе, чем предполагалось.

Проверили на том же Q4: поправили прямо в рантайме до 1.0, и модель начала адекватно работать. Интересно. С исходной силой 1.955 две задачи из трёх проваливались наглухо.

После этого пересобрали BF16 веса с силой 1.0 и нарезали EXL3 Q3, Q4 и Q5. Vision, MTP, всё на месте. Новые кванты тоже отдельно проверили - всё ок.

Короче смысл простыми словами в том, что частично эти тензоры отвечали за отказы модели. Но отказы не только отвечать на ТОНКИЕ вопросы, но и вообще на рефлексию самой с собой 😮 Типа она допустила ошибку и надо двигаться дальше и исправлять, но обратные веса этих векторов ломают эту логику.

Ловите 🤗
https://huggingface.co/collections/alesha-pro/qwen38-flash-next-abliterated-exl3-and-strata-gguf

Еще надо под Strata сделать, меня уже одолели все с этой стратой. Попробую добиться нормальной работы на одной RTX 3090 с выгрузкой части весов в RAM и PLE на SSD собственно у кого не хватит памяти. По хорошему бы GSQ + RCO, но рецепта нет под Qwen Flash Next


Video is unavailable for watching
Show in Telegram
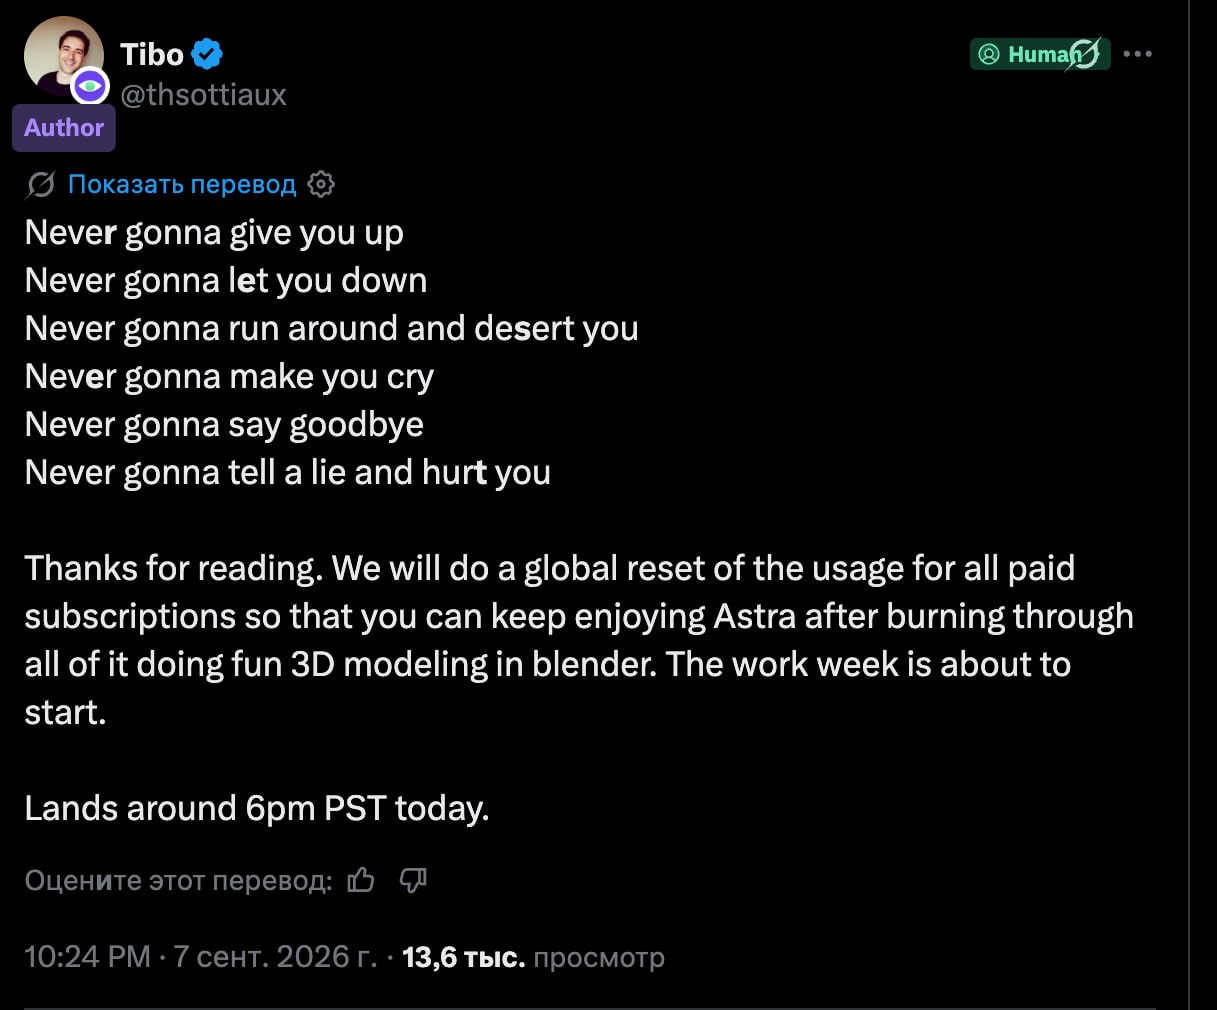
Запросы в Fable 5.1 сейчас частично направляются в Fable 5.5.

Проверяют его по знанию Тибо (thsottiaux в X) без гугла


Мы рады представить Qwen4 27B Is All You Need.

Эта работа формализует коллективное стремление сообщества LocalAI к локально развертываемому интеллекту.

Мы благодарим наших коллег за тщательный экспертный анализ и постоянный вклад в определение того, поместится ли это в VRAM

Пс. Ето мем, если что

995 0 3 34 33

теперь я понял почему оперативка подорожала

1k 0 17 4 28

Ну чтож, это было ожидаемо

1k 0 12 28 14


Лучшие, как всегда.


Там возня у OpenAI.

Типа самый масштабный DevDay за всё время. Представляют dots (автономные агенты).
Тариф за 500, GPT 6.1 Sol (Astra Minor), Astra Fast за 300$ на 1млн токенов output, ну и еще что-то.

Давайте не толпимся, расходимся, тут смотреть не на что.

https://openai.com/ru-RU/index/introducing-dots/


1.3k 1 12 14 12

Video is unavailable for watching
Show in Telegram
Я тут скилл накидал для моушн-дизайна на основе статьи одного из твиттерских.

https://github.com/alesha-pro/tools/tree/main/skills/motion-reel

Звезды как всегда нужны


Я начал войну двухбитных квантов между Mirai и PrismML. Мне её и заканчивать.

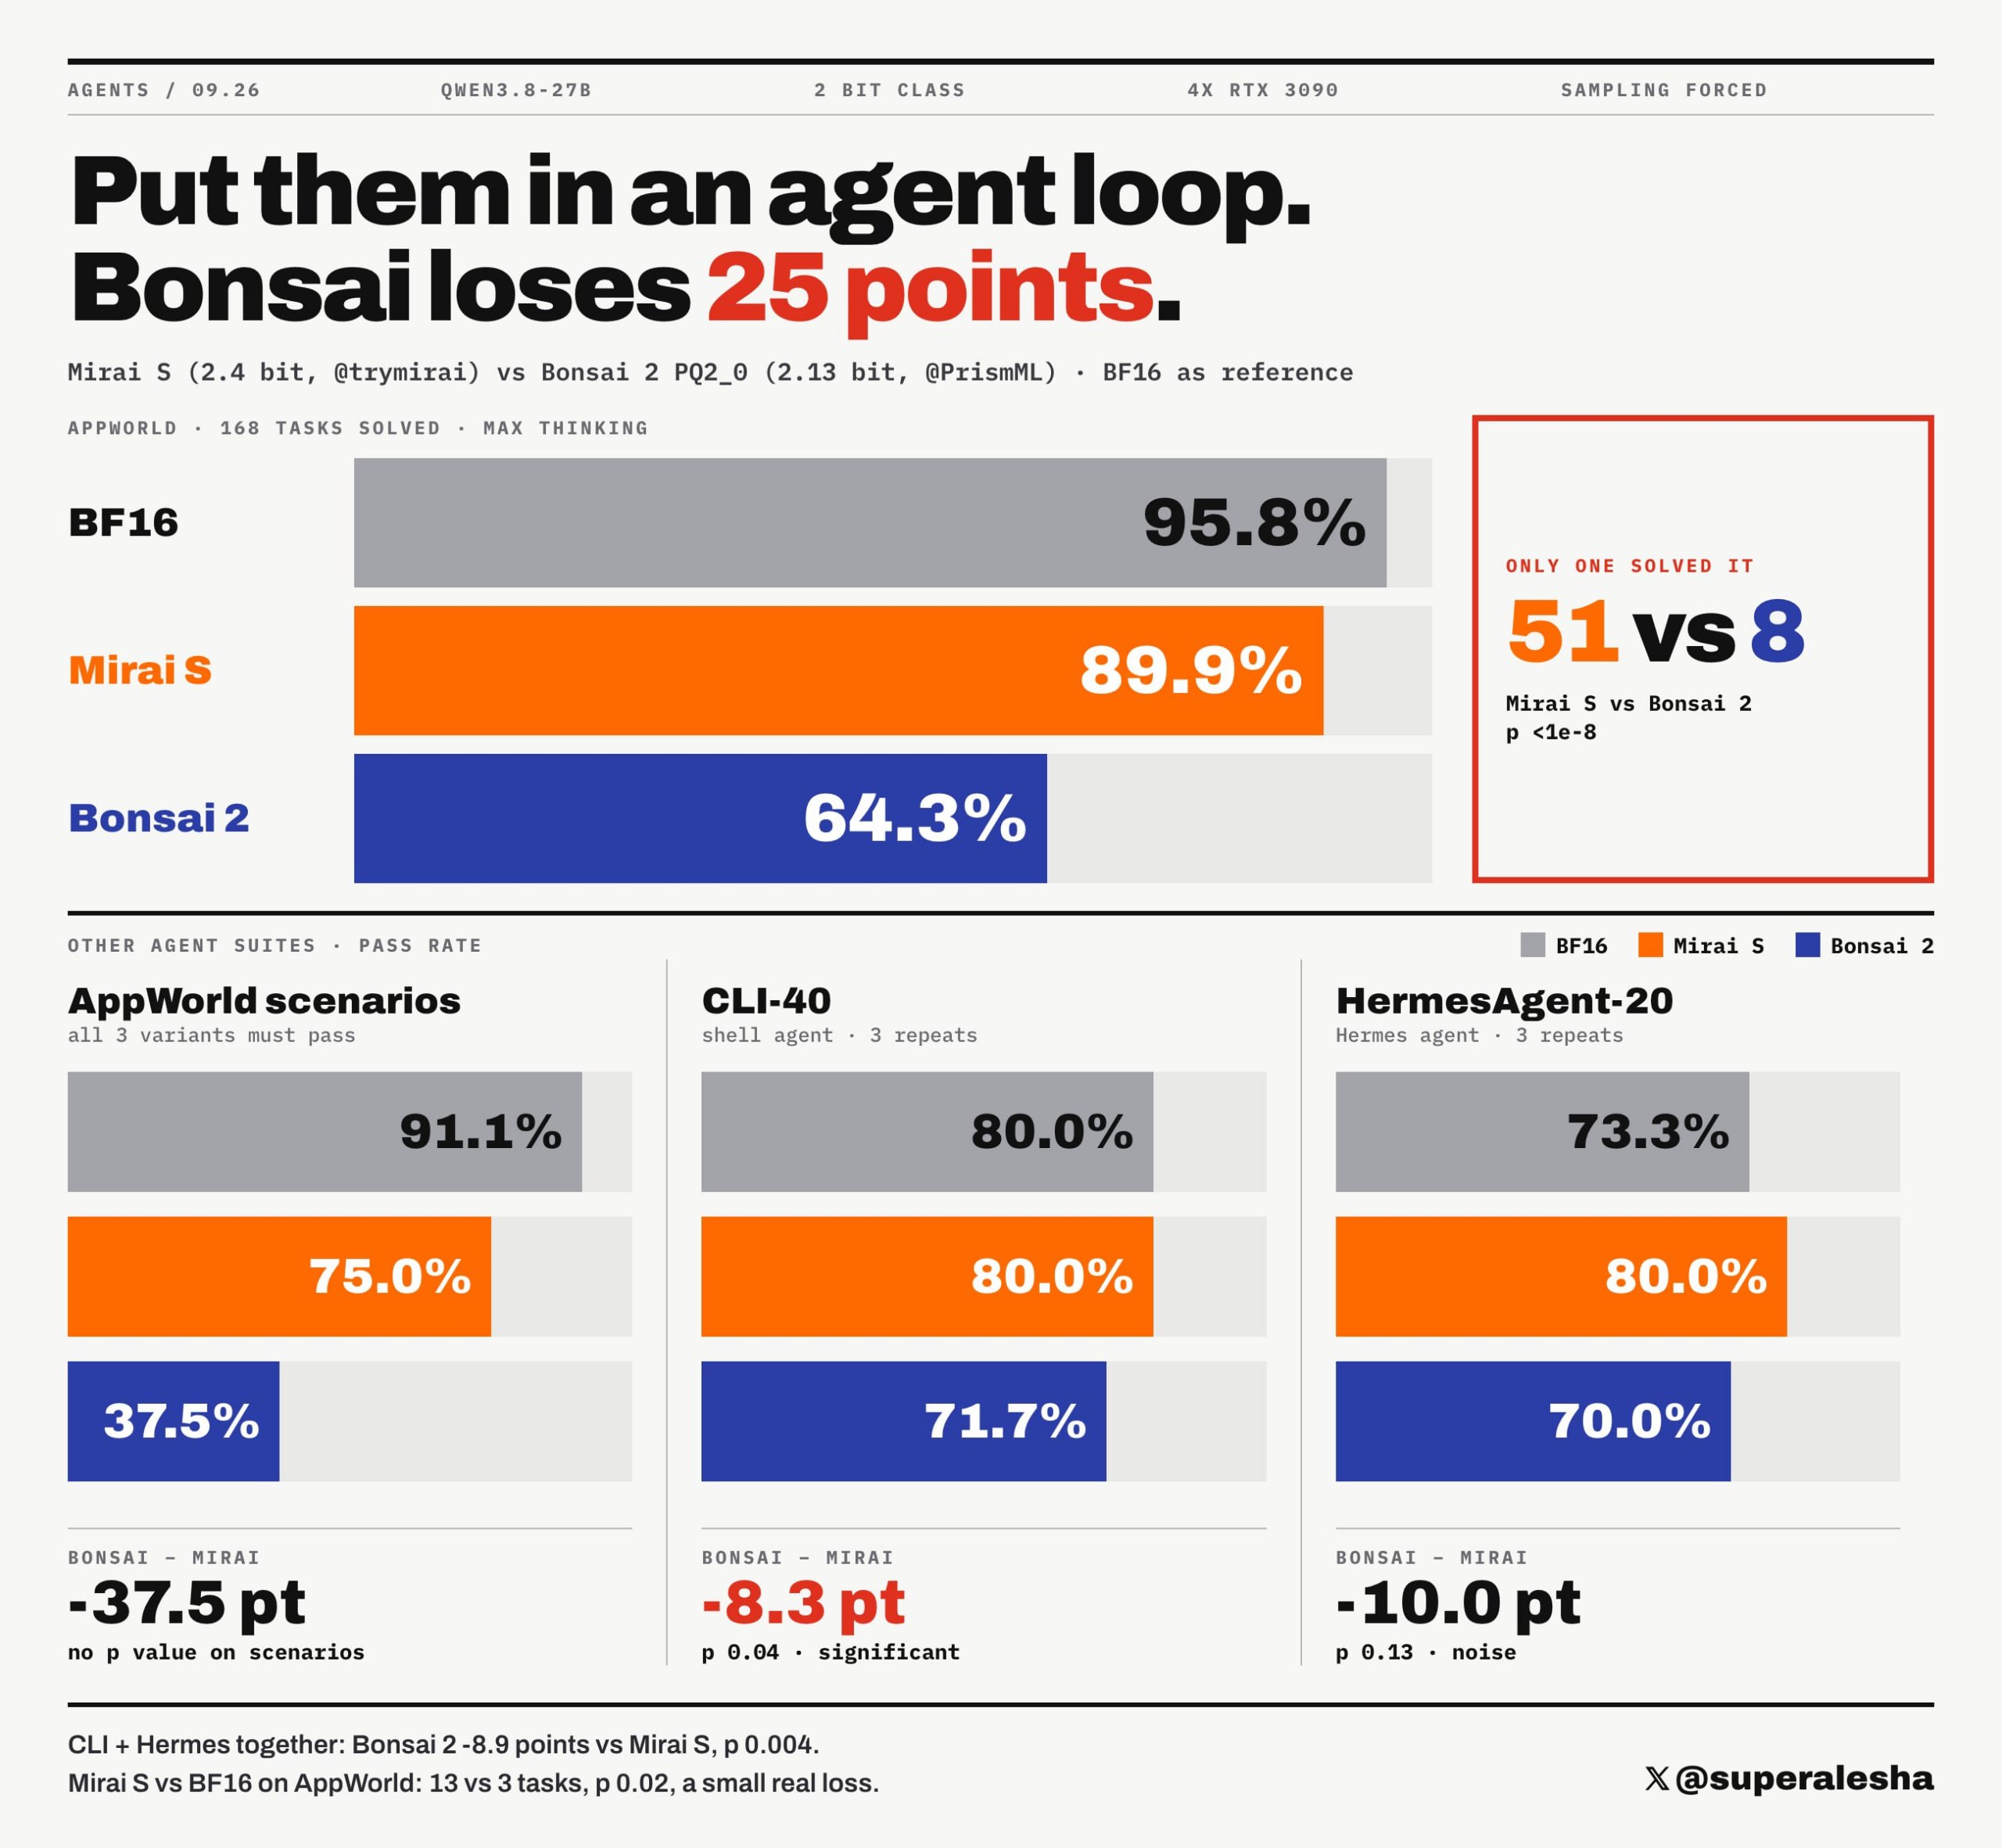
Сравнил 2 версии Qwen3.8 27B: Mirai S (8.45 ГБ) и Bonsai 2 (7.21 ГБ) на одинаковых задачах. Эталон как всегда BF16 через апишку.

На 300 one turn задачах плюс минус ничья: Mirai 78.4%, Bonsai 78.0%, BF16 80.3%.

Но стоит лишь чуть дать агентских задач 🤡
AppWorld, 168 задач в симулированных приложениях (там что-то типа Spotify, Venmo, Slack и тд) где модель пишет питон код и выполняет до 50 шагов:
⏺BF16: 95.8%
⏺Mirai S: 89.9%
⏺Bonsai 2: 64.3%

51 задачу решила только Mirai, 8 только Bonsai. В 16 failed задачах Bonsai зациклилась на тегах tool_call вместо Python. Даже без них заваленных 44 и 17 у Mirai.

На BenchLocal Bonsai тоже отстала на 8.9 пункта, а Mirai была на уровне BF16. Но Mirai выдаёт почти вдвое больше токенов: 12.2K против 6.8K у Bonsai. Тут явно перебор. Ну ребята говорят что это не финальная версия.

AppWorld я прогнал 1 раз. Агент отличается от того, что использовала команда Mirai, поэтому сравнивать можно только внутри моего прогона.

Для чата и разовых вопросов я бы взял Bonsai 2: меньше весит, короче думает. Для агентов из этих двух - Mirai S.

Война окончена 🤗

PS: на меня в твиттере фанатики PrismML набросились типа что я предвзят, за счет того что мне дали превью доступ к Mirai. Хтьфу на этих лжецов, это не так. Показываю и говорю как есть. Цифры выше.

PSS: спасибо чувакам из Mirai за то что максимально адекватные, в отличии от того деврела из PrismML.


Video is unavailable for watching
Show in Telegram
My bot hotter than your bot

Кажется я сделал настоящий бенгер.

Вангую - вы будете навевать припев ближайшие пару дней.

1.2k 0 27 33 36

⚡️⚡️

Запрунили 50% экспертов. Вероятнее всего русского там больше нет. Я сам делал прунинг, и да, русский там отлетает если не сохранять экспертов, отвечающих за него. Кому важно.

https://huggingface.co/ISTA-DASLab/Qwen3.8-Flash-Next-GSQ-RCO-Coder-GGUF

GSQ: https://arxiv.org/abs/2604.18556
RCO: https://arxiv.org/abs/2605.00649


Video is unavailable for watching
Show in Telegram

1.3k 0 39 29 23

Портировал 2.4-битную Qwen3.8-27B от Mirai в llama.cpp. Теперь она влезает в видеокарту на 12 ГБ со 128K контекста.

Одна RTX 3090 при 300 Вт, в пределах 12 ГБ:
128K с q4 KV: 11.3 ГБ
74K с q8 KV: 11.1 ГБ
decode 40 т/с, на 62K около 35 т/с
prefill около 1000 т/с
на 16 ГБ влезает 128K с MTP: 85 т/с на коде

Веса не переквантованы: сжатые коды Mirai лежат в GGUF бит в бит, и greedy-вывод совпадает с их плагином для vLLM. Vision модуль Mirai не выпустили, поэтому я собрал mmproj из базовой Qwen3.8 и запускаем его на CPU, видеопамять он не ест.

Заодно ускорил длинный контекст в самой llama.cpp: decode на 64K вырос с 27.9 до 35.2 т/с, prefill на 11%. Место для оптимизации еще есть.

По AppWorld от Mirai модель на 2.4 битах решает 57.9% задач, полная bf16 55.8%. На видео то, что она собрала сама как агент (тот прогон шёл через vLLM и на чистом pi.dev).

Код: github.com/alesha-pro/llama.cpp-mirai-s
Веса: huggingface.co/alesha-pro/Qwen3.8-27B-S-mirai-GGUF

PS: Pagoda Garden на видео моргает - это баг съемки Astra, я его не заметил. В последнем видосе полоски сквозь экран - это да, косяк кода LLM, а моргание - нет.

1.4k 1 68 83 22


19 last posts shown.