


Галлюциногенные SEO-тексты с протухшей инфой — почему ИИ их выдаёт и как это прекратить?
Как ни странно, одна из причин: заранее собранная база. Тот самый случай, когда фича оборачивается багом.
Перед тем как делать наш Human-assisted AI, я много тестировал похожие продукты от конкурентов. И заметил вот какой паттерн: инструменты, которые опираются на заранее собранные базы, чаще выдают устаревшую информацию и смешивают между собой продукты.
Например, в одном из тестов модели с предсобранной RAG, у нас получился текст, который начинался с обзора одного слота и заканчивался обзором другого. Просто потому, что на предсобранных данных похожие сущности дают близкие эмбеддинги, и retrieval вытягивает в топ чанки от нескольких слотов сразу.
Технологически вроде все сделано верно, но если не вчитываться и опубликовать, гугл сломает глаза. А сайт уйдет в те самые 90% тех кто "не взлетело — значит, гугловский рандом, наклепаем еще 10".
Я довольно долго думал, что с этим делать.
Заранее собранная база — в принципе неправильная идея для iGaming, где всё может поменяться за несколько дней, и есть куча похожих до неузнаваемости продуктов. Полные и актуальные данные о конкретном продукте, которые включают в себя бонусы, платежи, библиотеку игр, лицензии, условия, ограничения по гео, всегда будут выигрывать при прочих равных.
К тому же, кто и как собирал эту базу? Корректно ли прошел парсинг, с каких источников? А если три источника будут давать разные значения атрибутов сущностей — какое попадет к нам? На каком этапе происходит реконсиляция?
На выходе получается а) старая, б) каша. Каким бы дальше ни был процесс генерации, кого мы хотим этим удивить? А если не хотим, то зачем мы здесь? :-)
Поэтому в нашем Human-assisted AI мы решили перенести основное внимание на стадию Data Research.
Как она работает у нас?
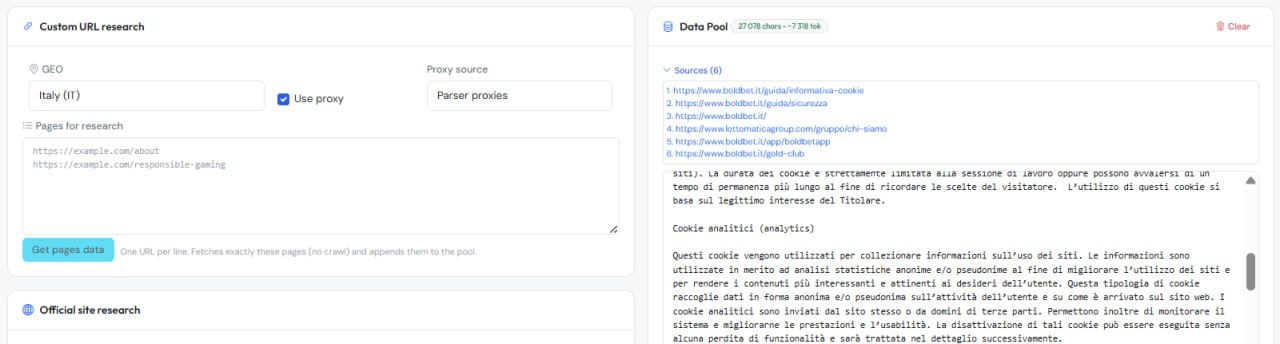
Под капотом несколько преднастроенных агентов по сбору источников: ИИ-парсер официального сайта бренда, парсер отдельно заданных страниц с условиями, распознавание скриншотов, и несколько других крутых дополнений. Все данные стекаются в Data Pool конкретной задачи.
Казалось бы, что такого? На рынке куча ии-агентов, которые одним нажатием кнопки бабло соберут все что нужно. Но есть нюансы, которые решают:
1) Входные страницы всегда задает оператор. Это гарантия того, что агент не начнет собирать инфу о CCTV {cable} slot вместо CCTV {casino} slot.
2) Наши авторы каждый день сталкиваются с тем, что самая уникальная и сладкая информация скрыта за регой. А рега это тот процесс, который сложно автоматизировать и масштабировать.
3) Зачастую часть данных живёт в виджетах, а не в тексте страницы. Это влияет коренным образом на парсинг, процент добытых данных и, конечно, на его стоимость. И как бы мы ни фанатели от ИИ-агентов, универсального и автоматического парсера за 20 лет работы с парсерами я не видел. За последние годы — тоже.
Между тем эта информация может составить тот самый Information Gain, за которым охотится Гугл. То есть это реально то, что в конечном счете выделит вас из серой толпы ИИ-рерайтеров casinoreview (те, которые топ-20).
Поэтому оператор может в полуручном режиме пройти регу, разметить данные и одним кликом добавить их в Data Pool конкретной задачи (статьи).
Что по ресурсам?
Благодаря автоматизациям, удобному окружению, системе "одного окна" и — о чудо! — опытному оператору, который знает где искать, мы получаем уникальный набор данных, который еще за три этапа до генерации текста уже делает его выдающимся.
Если хотите проверить этот подход на своих страницах, можем взять несколько задач в тест и показать разницу на конкретных продуктах, GEO и URL.
Владимир,
Founder iGamingTextLab