


Как заставить ИИ запоминать правила проекта и не искажать их со временем?
Это был один из первых вопросов, которые мы решали на уровне архитектуры, когда собирали инструмент под наш Human-Assisted AI.
Проблема знакома всем, кто много работает с моделями: и в массмаркетных ИИ, и в кастомных инструментах. Со временем модель начинает трактовать правила проекта по-своему или терять их. А когда требования дорабатываются по ходу, становится хуже: в одном растущем чате самая свежая правка стоит ближе всего к генерации и по факту перевешивает, даже если по важности она второстепенна. Модель читает её как уточнение, а не как дополнение. Новое требование молча продавливает старое, более значимое.
Корень в том, где эти правила живут. Если они лежат в истории переписки, модель каждый раз собирает картину проекта заново из растущего контекста сообщений и достраивает пробелы своим дефолтом (каким — всегда сюрприз). При этом внимание модели распределяется неравномерно: в приоритете начало и конец контекста, а середина проваливается.
То есть правило, брошенное в чат десятым сообщением из шестидесяти, попадет в мёртвую зону. А когда чат становится слишком длинным, история сжимается, и правило не просто теряет вес, а сохраняется лишь в пересказе, тогда как часто нам нужны именно дословные формулировки.
К тому же, часто сами того не замечая, мы даем противоречащие друг другу инструкции. Получается что-то вроде:
а потом где-то добавим:
И еще в каком-нибудь контексте:
В итоге у регулятора там будет два слова, и никаких абзацев мы не получим. Либо получим нечто среднее.
Чинить это руками можно ровно одним способом: каждый раз прописывать всё заново, от редполитики до последних правок клиента. Много ручной работы, и при масштабировании такую схему ждёт коллапс. Автоматизацию мы затевали ради обратного.
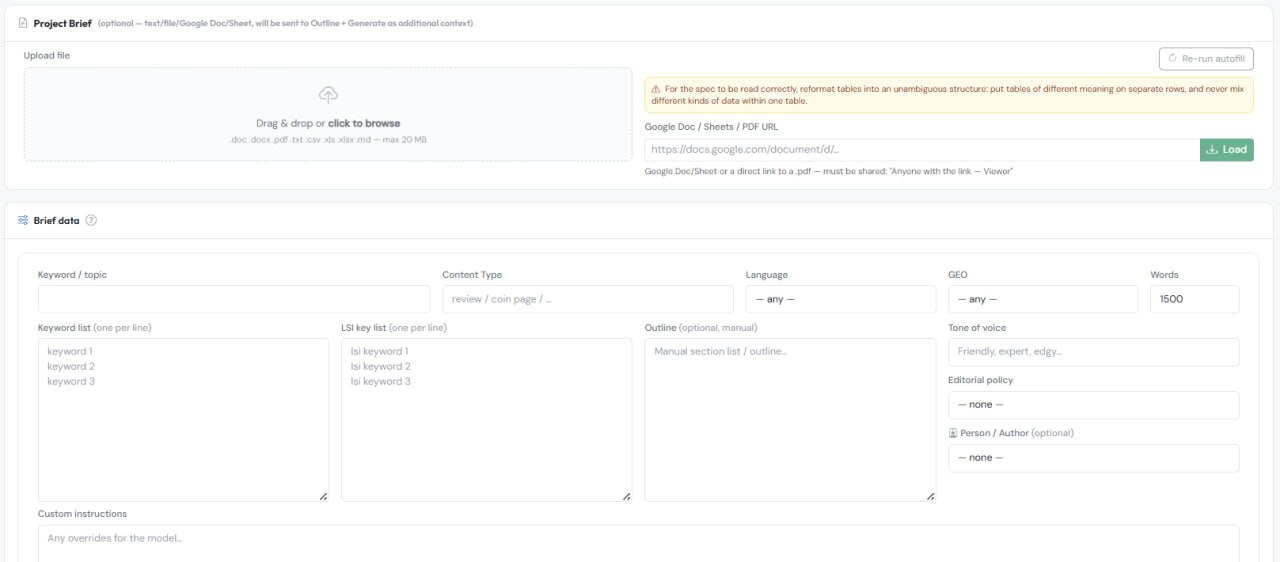
Поэтому в нашем внутреннем инструменте генерации Редполитика (Editorial Policy) вынесена в отдельный слой.
Ключевая мысль: бриф, ресёрч, голос и правила проекта — это разные типы информации с разным сроком жизни, и держать их в одном промпте ошибочно. Мы разводим их по отдельным полям:
— Brief описывает конкретный материал и живёт один текст;
— Research даёт фактическую базу на сейчас;
— Tone of Voice и персона задают голос;
— Editorial Policy хранит постоянные редакционные правила целого проекта и переживает каждый материал.
По ходу работы требования проекта дополняются. Клиент оставляет новые комментарии, а редактор отделяет разовые замечания от общих и добавляет в Editorial Policy только те правки, которые должны учитываться в следующих материалах.
Так, знания о проекте не остаются внутри отдельного чата. Они хранятся в системе, обновляются по мере работы и заново передаются модели при работе над каждым новым материалом.
На небольшом объёме это избавляет команду от постоянного повторения одних и тех же вводных. На сотнях и тысячах материалов помогает удерживать единые редакционные требования.
Правда, остаётся ещё одна проблема: наличие правила в контексте не гарантирует, что модель его выполнит. О том, как мы проверяем результат, расскажу отдельно.
Кстати, скоро будут первые отзывы по нашему новому сервису:)
Если хотите попробовать бесплатно, набор ещё открыт 👉 @igamingtextbot
Вова,
Founder iGamingTextLab
Это был один из первых вопросов, которые мы решали на уровне архитектуры, когда собирали инструмент под наш Human-Assisted AI.
Проблема знакома всем, кто много работает с моделями: и в массмаркетных ИИ, и в кастомных инструментах. Со временем модель начинает трактовать правила проекта по-своему или терять их. А когда требования дорабатываются по ходу, становится хуже: в одном растущем чате самая свежая правка стоит ближе всего к генерации и по факту перевешивает, даже если по важности она второстепенна. Модель читает её как уточнение, а не как дополнение. Новое требование молча продавливает старое, более значимое.
Корень в том, где эти правила живут. Если они лежат в истории переписки, модель каждый раз собирает картину проекта заново из растущего контекста сообщений и достраивает пробелы своим дефолтом (каким — всегда сюрприз). При этом внимание модели распределяется неравномерно: в приоритете начало и конец контекста, а середина проваливается.
То есть правило, брошенное в чат десятым сообщением из шестидесяти, попадет в мёртвую зону. А когда чат становится слишком длинным, история сжимается, и правило не просто теряет вес, а сохраняется лишь в пересказе, тогда как часто нам нужны именно дословные формулировки.
К тому же, часто сами того не замечая, мы даем противоречащие друг другу инструкции. Получается что-то вроде:
"Абзац про лицензию напиши максимально подробно"
а потом где-то добавим:
"Не делай абзацы больше 50 слов"
И еще в каком-нибудь контексте:
"Лицензию напиши в точности, как написано у регулятора"
В итоге у регулятора там будет два слова, и никаких абзацев мы не получим. Либо получим нечто среднее.
Чинить это руками можно ровно одним способом: каждый раз прописывать всё заново, от редполитики до последних правок клиента. Много ручной работы, и при масштабировании такую схему ждёт коллапс. Автоматизацию мы затевали ради обратного.
Поэтому в нашем внутреннем инструменте генерации Редполитика (Editorial Policy) вынесена в отдельный слой.
Ключевая мысль: бриф, ресёрч, голос и правила проекта — это разные типы информации с разным сроком жизни, и держать их в одном промпте ошибочно. Мы разводим их по отдельным полям:
— Brief описывает конкретный материал и живёт один текст;
— Research даёт фактическую базу на сейчас;
— Tone of Voice и персона задают голос;
— Editorial Policy хранит постоянные редакционные правила целого проекта и переживает каждый материал.
По ходу работы требования проекта дополняются. Клиент оставляет новые комментарии, а редактор отделяет разовые замечания от общих и добавляет в Editorial Policy только те правки, которые должны учитываться в следующих материалах.
Так, знания о проекте не остаются внутри отдельного чата. Они хранятся в системе, обновляются по мере работы и заново передаются модели при работе над каждым новым материалом.
На небольшом объёме это избавляет команду от постоянного повторения одних и тех же вводных. На сотнях и тысячах материалов помогает удерживать единые редакционные требования.
Правда, остаётся ещё одна проблема: наличие правила в контексте не гарантирует, что модель его выполнит. О том, как мы проверяем результат, расскажу отдельно.
Кстати, скоро будут первые отзывы по нашему новому сервису:)
Если хотите попробовать бесплатно, набор ещё открыт 👉 @igamingtextbot
Вова,
Founder iGamingTextLab