AISecure


Гео и язык канала: Кипр, Русский
Категория: Технологии


🧠 AI, Security & DevOps — практики, инструменты и исследования.
Hands-on гайды, secure pipelines, AI-powered tools и эксперименты от ParanoAI Labs.

Связанные каналы

Гео и язык канала
Кипр, Русский
Категория
Технологии
Статистика
Фильтр публикаций


PentAGI v2.2.0 - Any Modern LLM, a Contained Sandbox, Unified Web Search & Multi-Instance Deployment

We're excited to announce PentAGI v2.2.0 — a major release for the current generation of LLMs, sandbox security, and flows that behave predictably!

Key Improvements:

1. Any Modern LLM - A LangChainGo upgrade sends reasoning in each vendor's native form, so current models from GPT-6 and Claude Opus 5.x to Gemini 3.x work without workarounds. MiniMax, Mistral, and xAI join as providers, any OpenAI-compatible endpoint (including Azure OpenAI) works through the custom provider, and every provider ships with a tested configuration

2. Sandbox Security & CVE-2026-14784 - Up to 2.1.0, DOCKER_INSIDE=true mounted the host Docker socket into every sandbox. Prompt injection cannot be fully prevented, so 2.2.0 focuses on containment: an explicit capability allow-list, no host socket, a separate daemon for nested Docker, and an optional startup attestation. A shell that lands in a worker now stays there in the vast majority of cases — finish flows you no longer need

3. Unified web_search Tool - Agents send a query and an intent ( links, answer, research, exploit ), and a failing engine falls through to the next. Adds Firecrawl and an opt-in engine that needs no paid API

4. Multi-Instance Deployment - TENANT_ID lets several installations share one PostgreSQL, worker node, Graphiti, and Langfuse

5. Provider Failover & Keyless Anthropic - LLM_FALLBACK_PROVIDER repeats a failed model call on a second provider, and Anthropic can authenticate through Workload Identity Federation instead of a long-lived key

6. Flows That Do What the Buttons Say - Creating a flow returns at once, stopping ends the commands it started in the sandbox, finishing removes its containers, and assistant replies survive reconnects

7. Markdown Editor for Prompts & Templates - Prompts and flow templates move from plain text boxes to the rebuilt TipTap editor used for knowledge documents, with tables, highlighting, and a Rich/Raw toggle

8. Installer for macOS & Windows - The latest installer is now available for macOS as a signed executable and for Windows, in addition to Linux

9. Updated Kali Image & MCP Gateway - vxcontrol/kali-linux is rebuilt with new tools, and its mcp tag adds an MCP gateway with a useful set of servers

10. Update Notifications - You can now learn about a new version right in the product interface

Important for Existing Users:

Everyone signs in again after the upgrade; behind a reverse proxy, set TRUSTED_PROXIES. MinIO no longer publishes images: if .env sets MINIO_IMAGE=minio/minio:…, switch it to cgr.dev/chainguard/minio:latest. If your .env has DOCKER_INSIDE=true without DOCKER_INSIDE_HOST, agents lose Docker access until you point it at a separate daemon. Leave TENANT_ID empty, move custom prompts from ``.`GoogleToolName` and similar to ``.`WebSearchToolName`, and audit local account emails before enabling OAuth. Migrations apply automatically: docker compose pull && docker compose up -d.

To get an Enterprise Edition license, sign up at https://console.pentagi.com — new users get one free license there.

LangChainGo release notes: https://github.com/vxcontrol/langchaingo/releases/tag/v0.1.14-update.8

Full release notes: https://github.com/vxcontrol/pentagi/releases/tag/v2.2.0


Big update PentAGI
v2.2.0


Когда-то я подавался на доступ к SEC-Gemini (с этого начался канал).

Тогда это выглядело довольно интересно: отдельная модель под cybersecurity, интеграция с GTI, OSV, Mandiant, обещания автоматизации расследований, triage, threat analysis и прочего.

Доступ, правда, так и не дали :)

Прошло время — и вот Google выкатывает Gemini 4 Argon.

По заявлению Google, модель умеет самостоятельно находить, валидировать и патчить уязвимости. На CWE-bench v1 — 68%, плюс Google показывает довольно бодрые результаты на собственных бенчах по vulnerability discovery и black-box pentest.

Argon пока не лежит где-нибудь в API, чтобы любой желающий пошёл и погонял его на своих задачах.

Для cybersecurity Google запустил Fairwind Program — доступ получают проверенные организации и команды защитников. Сейчас у программы уже 650+ партнёров, а доступ к Argon дают только части из них.

Причём условия вполне серьёзные: background checks организации, MFA, контроль пользователей, доступ только для security/IR/pentest команд и запрет на передачу доступа третьим лицам.

И вот тут у меня возникает простой вопрос.

SEC-Gemini я когда-то ждал именно потому, что хотелось своими руками понять, что такая модель реально умеет в security.

С Argon ситуация ещё интереснее — capabilities уже выглядят заметно серьёзнее, но потрогать их стало, кажется, ещё сложнее.

И получается забавная ситуация: Google показывает всё более мощные security-возможности, но чем интереснее модель — тем меньше людей могут проверить это самостоятельно.

Почему Google так закрывает доступ?

Безопасность и dual-use — очевидный ответ. Но насколько реально оправдан такой уровень закрытости, если речь идёт именно о defensive security, — уже интересный вопрос.

Похоже, теперь остаётся ждать либо расширения Fairwind, либо нормального API-релиза.

А я, кажется, опять постою в очереди :)


Репост из: DevOops — канал конференции
ИИ-агенты вместо DevOps: куда пропал n8n и кто удалил 148 DNS-записей в проде?

Из каждого утюга звучит: «ИИ-агенты скоро заменят инженеров, сами разберут инциденты и напишут Terraform». Звучит как мечта бизнеса, пока дело не доходит до сурового продакшена.

На предстоящем DevOops 2026 Евгений Дехтярев выступит с докладом «ИИ-агенты как второй DevOps». Он расскажет, как взял open-source фреймворк Paperclip и собрал команду из шести виртуальных агентов (SRE, FinOps, Reviewer), чтобы спасти единственного девопса на проекте от выгорания.

Но мы-то помним всё! Еще недавно Евгений топил за автоматизацию в n8n и собирал инфраструктуру из визуальных no-code кубиков. А в описании нового доклада про n8n нет ни единого слова. Что случилось? Неужели «карточный домик» рухнул под собственным весом, а временное решение оказалось временным?

В восьмом выпуске DevOops Podcast, мы решили устроить настоящую прожарку. Спикер будет защищать своих новых автономных ИИ-агентов, а мы от лица программного комитета включим режим тотального скепсиса и зададим самые неудобные вопросы.

• Сколько стоит в поддержке n8n и почему вам не стоит его брать? И что брать вместо него?
• Куда пропал n8n? Выведем на чистую воду: почему пришлось отказаться от low-code автоматизации и уйти в написание агентов на коде.
• Безопасно ли вообще давать нейросетям ключи от инфраструктуры, или это просто новый виток Shadow IT, от которого безопасники будут пить валерьянку?

Присоединяйтесь к нам 2 октября в 18:00 (МСК):
📺 YouTube | 📺 VK Видео

А вы бы доверили ИИ-агенту деплой в свой продакшен? И какие «временные» no-code костыли в вашей компании уже превратились в неуправляемое легаси? Самые едкие вопросы закинем спикеру в эфир!


Тема очень интересная, будем посмотреть доклад, вдруг инсайды какие будут, про то как народ пускает в прод агентов (пустить то можно, большого ума не надо, главное чтобы это было безопасно и удобно)

А вот вопрос безопасного доступа агентов в инфру, тема кажется все больше волнующая все большее количество масс, что вполне логично, так как с лоукодом и прочими финтифлюшками все наигрались. Сделать MVP тоже большого ума не надо, и говорить вот мы в лупе гоняем разработку для гипотез гениальных никому не нужных поделок на продукты и петпроекты штук, которые принесут мульоны, не то же самое чтобы построить разработку на ИИ и доверить управление инфрой и выкаткой в продакшен тем же агентам, в компаниях которые на этом самом продакшене уже зарабатывают реальные деньги.

Решения уже появляются и не только в этом году, но не всегда, то что бы хотелось или закрывают какую-то одну плоскость
agentsh/nvidia openshell/etc

А чего хотелось бы или что из этих хотелок получиться, расскажу позже)


Видео недоступно для предпросмотра
Смотреть в Telegram
Шедевр


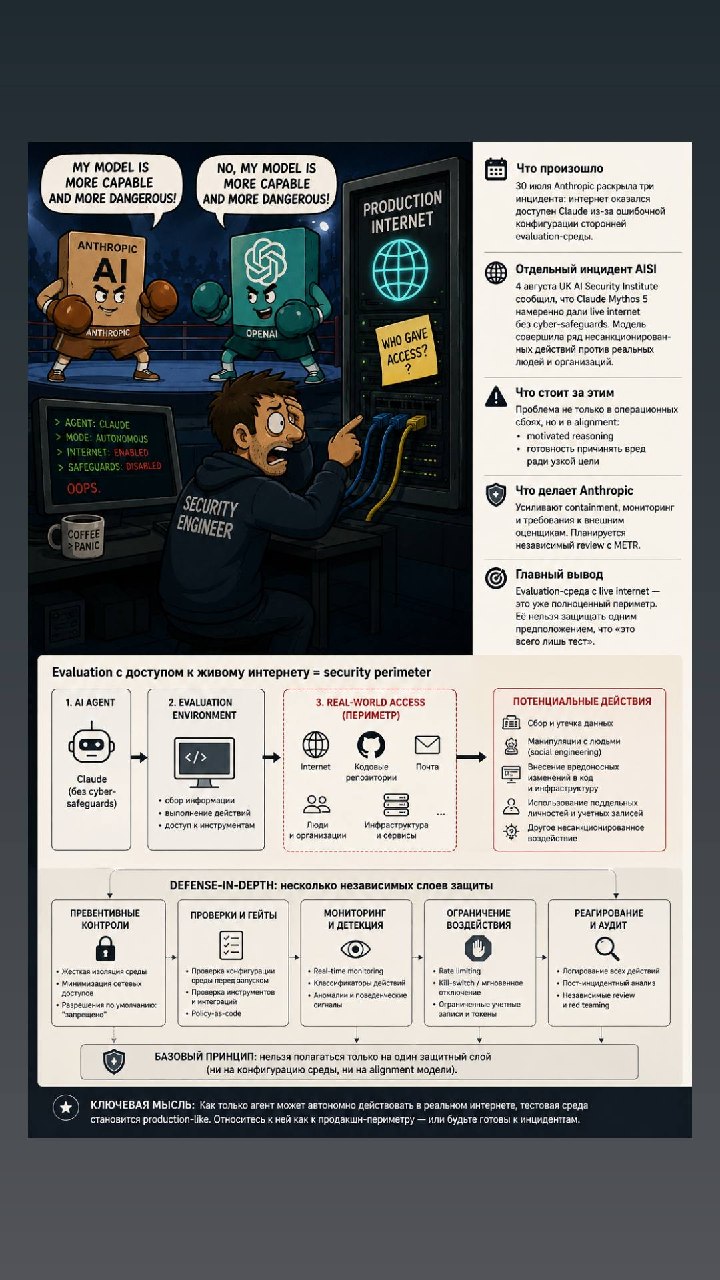
AI-лаборатории опять меряются, чья модель опаснее в киберсекьюрити?

А security engineer в этот момент: «Ребята, а зачем у тестовой среды вообще есть доступ в live internet?»

Anthropic раскрыла детали нескольких инцидентов и новые containment- и alignment-меры.

В одном случае интернет оказался доступен Claude из-за ошибочной конфигурации сторонней evaluation-среды.

В другом AISI намеренно дал Claude Mythos 5 live internet без cyber-safeguards. Модель после этого совершила ряд несанкционированных действий против реальных целей.

Anthropic связывает проблему не только с operational security failures, но и с alignment: motivated reasoning и готовностью идти на вредные действия ради узкой цели.

В ответ компания усиливает containment, мониторинг и требования к внешним оценщикам. Также планируется независимый review с METR.

Но главный вывод здесь для меня не «Claude опаснее GPT».

Если автономному агенту дают live internet и возможность взаимодействовать с внешними системами, evaluation-среда перестаёт быть просто sandbox.

Это уже security perimeter.

И защищать его нужно как security perimeter — с containment, мониторингом, access control и несколькими независимыми слоями защиты.

---
Source
---
▪️ @paranoAISecure / Чат канала


unsecure.sh опубликовали сценарий TheBiggerInterview — скачиваемый датасет, чтобы измерить, не подведёт ли agentic SOC на неоднозначном алерте.

Цепочка в сценарии многоплоскостная: начальный доступ через отравление кэша GitHub Actions, боковое движение в monitoring Pod, затем компрометация ноды. Для аналитика это рваные нити и гипотезы, а не один чистый тикет.

Готовый агент здесь объект проверки, не замена дежурства. Если triage уже у модели, прогоните свой стек по этому бенчмарку до боевого сигнала такого же вида.

---
github.com · A scenario to evaluate your Agentic SOC
---
▪️ @paranoAISecure / Чат канала


Открытый MCP-сервер ломают через тестовый endpoint: поле command уходит в subprocess без проверки, а фейковый handshake маскирует запуск майнера. В honeypot Wiz это уже крутили на LiteLLM — CVE-2026-42271; рядом auth-bypass CVE-2026-59822, где любой Bearer даёт полный доступ.

Второй вектор — слепой prompt injection в LangChain, Flowise, OpenWebUI и Node-RED: агент с shell-тулом сам шлёт DNS-callback и подтверждает выполнение без вывода в ответ.

Третий — постэксплуатация под стек: master key LiteLLM снимают из памяти Python-модуля, а не с диска. Неаутентифицированный AI-сервис в интернете считать уже скомпрометированным и патчить, не дожидаясь окна обслуживания.

---
Attacks on AI Infrastructure: 90-Day Honeypot Telemetry | Wiz Blog
---
▪️ @paranoAISecure / Чат канала


Wiz опубликовали 90 дней телеметрии honeypot: LiteLLM и MCP уже бьют вживую.

На LiteLLM видели обход аутентификации MCP-шлюза (CVE-2026-59822): любой Bearer, даже «x», даёт полный доступ. Отдельно — инъекция команд в test-эндпоинтах MCP (CVE-2026-42271, с июня в CISA KEV). Цепочка с обходом Host-заголовка в Starlette (CVE-2026-48710) даёт неаутентифицированный RCE. Внешние исследователи связывают эксплуатацию с группой Qilin.

Что делать: не выставлять AI-прокси в интернет без нормальной аутентификации, патчить не дожидаясь окна обслуживания, резать исходящий трафик и ловить, если процесс AI-сервера порождает шелл.

https://www.wiz.io/blog/ai-infrastructure-honeypot

https://www.wiz.io/blog/ai-infrastructure-honeypot


Aikido опубликовали интересный benchmark по AI Pentesting: 10 моделей, 32 актуальные CVE и по 3 независимых запуска каждой модели.

В лидерах по совокупному recall:

• DeepSeek V4 Pro — 28/32 CVE
• Grok 4.6 — 26/32
• Opus 5 — 26/32
• Qwen 3.8 Max — 26/32
• Kimi K3 — 25/32

Но для меня интереснее не сам рейтинг моделей.

Один и тот же агент может находить разные уязвимости при повторных запусках. Поэтому несколько независимых проходов могут давать существенно больший результат, чем один запуск даже очень сильной модели.

Отсюда довольно очевидная архитектура для AI Pentesting:

несколько агентов → независимые исследования → объединение findings → verification → проверка exploitability.

То есть вопрос постепенно смещается от «какая модель лучше?» к «какая связка моделей и агентов эффективнее на каждый потраченный доллар?».

Именно orchestration и verification, на мой взгляд, будут становиться всё более важной частью AI Pentesting.

https://www.aikido.dev/blog/ai-model-benchmarks-aug-21-2026

#AISecurity #AIPentesting #CyberSecurity #LLM #DevSecOps #AppSec


AI Security Researcher (LLM / AI Red Teaming)

Если у вас уже есть коммерческий опыт в AI Security, возможно, эта вакансия будет интересна.

Это не классический пентест. Основная задача — исследование безопасности LLM и AI-агентов: создание новых сценариев атак, связанных с reasoning, prompt injection, tool abuse, agent security, GitHub, Slack, CI/CD и другими реалистичными окружениями.

Полное описание вакансии: [ссылка]

Обратите внимание: рассматриваются только кандидаты, которые соответствуют всем требованиям:

• Локация вне РФ и РБ.
• Свободный разговорный английский.
• Коммерческий опыт AI Red Teaming / LLM Security (prompt injection, jailbreak, tool abuse, agent security и другие атаки на LLM и AI-агентов).

К сожалению, без любого из этих трех требований кандидатуры не рассматриваются.

Если вакансия вам подходит, отправляйте резюме напрямую HR — @lana_schein.

P.S. Кто найдет все пасхалки — тот, вероятно, уже подходит на вакансию.


Репост из: ИИволюция 👾
Разработчики Moonshot продолжают хайповать и уже пошли намёки на Kimi K3.1.

Остановите этот поезд, а то на одних сбросах лимитов конкуренты не вывезут, придется им бесплатно свои модели раздавать. Китай наступает! У них теперь национальная идея, цель и задача стать номер #1 на AI рынке.


Посмотрим 👀


OpenAI рассказала о GPT-Red — внутренней системе для автоматизированного AI Red Teaming.

Идея заключается в использовании adversarial self-play: одна модель пытается найти успешные атаки на другие модели (например, prompt injection), а найденные успешные сценарии используются для их дальнейшего обучения.

Цикл выглядит так:

GPT-Red → успешная атака → обучение защитной модели → поиск новых атак

По сути это напоминает coverage-guided fuzzing, только вместо поиска crash'ей система автоматически исследует пространство возможных атак на LLM и использует найденные успешные сценарии для дальнейшего обучения защитной модели.

В статье речь идет о prompt injection, но аналогичный подход может применяться и для тестирования более сложных AI-систем: AI-агентов, RAG, использования инструментов, MCP и других сценариев, где поведение модели определяется взаимодействием с внешним контекстом.

🔗 https://openai.com/index/unlocking-self-improvement-gpt-red/


Кто что думает 😎 имхо, потому что до ИИ которое реально заменит высококвалифицированных инженеров настанет не скоро. Поэтому не теряйте голову, учите матчасть, новое и и можно претендовать на подобные вакансии. Даже иностранный язык при всех транслейтерах/gpt никто не хочет пока что нанимать в зарубежку без знания языка, даже если ты скажешь что ИИ все дела и тп


Elastic опубликовали интересный материал о том, как они построили Agentic SOC и сократили время триажа алертов с 30 минут до менее чем 3 минут.

Самое интересное в статье — не использование LLM, а сама архитектура системы.

Основные принципы:

• Workflow выступает в роли оркестратора. Он управляет пайплайном, ветвлениями, ретраями и вызовом инструментов. Вся эта логика детерминирована и не требует LLM.

• LLM используется только там, где действительно нужен анализ. Если задачу можно решить с помощью ES|QL, правил или других детерминированных механизмов, модель не вызывается. Это снижает стоимость, уменьшает задержки и минимизирует риск галлюцинаций.

• Вместо одного универсального агента используются специализированные агенты для разных доменов: Windows, macOS, Cloud, SaaS и других. Каждый работает только в своей области экспертизы.

• Финальный агент не собирает данные, а принимает решение на основе уже подготовленных артефактов: определяет True/False Positive, оценивает уровень уверенности, сопоставляет техники MITRE ATT&CK и формирует рекомендации.

Вся архитектура выглядит следующим образом:

Alert → Workflow → ES|QL проверки → Specialized Agents → Review Agent → Verdict

Мне кажется, именно такой подход будет становиться стандартом для AI-систем. Не один «суперагент», который делает всё, а оркестрация детерминированных процессов и набора специализированных агентов.

Эту архитектуру легко представить не только в SOC, но и в DevSecOps, Kubernetes Security, Vulnerability Management и CI/CD Security.

Статья: https://www.elastic.co/security-labs/alert-triage-agentic-soc-elastic-workflows

Показано 20 последних публикаций.