
do...while...ai


Kanal geosi va tili: ko‘rsatilmagan, Ruscha
Toifa: ko‘rsatilmagan


Заметки ненастоящего программиста. ИИшница и другие радости разработки.

Bog‘liq kanallar

Kanal geosi va tili
ko‘rsatilmagan, Ruscha
Toifa
ko‘rsatilmagan
Statistika
Postlar filtri


Экспериментирую с мобильным рабочим местом. Дома M4 Max с тремя мониторами, а на ходу — M4 Air 11”. Между ними tailscale + Screen 5. Весь оригинальный сетап с собой под мышкой можно носить. Остальные варианты типа remote control и всякие веб-клиенты — «жалкое подобие левой руки». Маленький 11” экранчик — это неудобно, но что поделать. Эта плата за мобильность. Все же удобнее, чем с телефона. Месяц пока, полет нормальный.


Ненасытная жажда нового

Мысль дня: лучше освоить один инструмент для выполнения какой-то работы очень хорошо, чем бесконечно гоняться за новинками, в которых за тебя (для тебя) пытаются упростить ту самую работу.

Сейчас от количества новых тулзов голова идет кругом. Можно только и делать, что сидеть за компом и тестировать новые релизы инструментов. Иногда, просто чтобы держать руку на пульсе, иногда, чтобы попытаться найти облегчение своим страданиями, иногда, чтобы действительно найти новый более эффективный вариант выполнения работы. И это, безусловно, интересная рутина (интереснее, чем багфикс в своём софте, или настройка CI пайплайнов, или чтение/написание каких-то инструкций, отчетов и прочей рутины). Но само по себе тестирование новинок не сделает текущую работу за нас, а вот время скорее всего отнимет.

В какой-то момент пришёл к мысли, что в погоне за новыми IDE и десктопными аппками/тулзами для работы с агентами или для автоматизации, я трачу половину времени просто на то, чтобы найти в них привычные функции, понять концепцию приложений, настроить тулзу под себя или под нужный воркфлоу. Я так и не смог привыкнуть к десктопному OpenAI ChatGPT (+Codex), в котором теперь можно и вопросы задавать, и кодировать, и ещё бог весть что делать. Привыкание и кастомизация съедает кучу времени, а основная работа стоит. И, как правило (по-крайней мере у меня), после перехода на новый модный и молодёжный тул производительность вырастает не настолько, насколько было затрачено времени на его изучение и настройку. Кажется, что в долгую оно должно приводить к росту производительности, но к тому времени, как это "в долгое" наступает, на горизонте возникает еще 40 других тулов, на которых уже пора пересаживаться. Это одна из причин (конечно, не главная, но всё же) , почему с популяризацией вайбкодинга люди начали на работу тратить времени больше, а не меньше. И только ты настроил всё под себя, и привык к работе в новом IDE или с новым инструментом, как выходит что-то ещё более яркое и блестящее. И вот опять нужно изучать, тестировать, узнавать, кастомизировать, привыкать.

Короче, я тут подумал, что надо бить себя по рукам за это и держать фокус на выполнении работы. Потому что оно не даёт такого буста и часто ничего принципиально не меняет. Привыкли работать в vim? Помните, знаете все шоткаты? Не нужно перелезать на Warp Terminal, в vim скорее всего вы сделаете всё намного быстрее. А когда будет "сильно жать" по функциям, вот в этот момент стоит осмотреться, и выбрать следующий тул, который станет заменой. Здесь имеет смысла потратить время на поиск, тестирование, кастомизацию. И успокоиться еще на полгода-год.


Новости с полей

У меня пара новостей: хорошая и плохая.
Начну с плохой: совершенно случайно сегодня я сделал /effort у Claude сессии и обнаружил, что почти неделю работал на medium уровне. Обычно у меня было xhigh. Но жуки из Антропик втихую убрали индикатор effort'а из статусной строки и сбросили у сессий дефолтный уровень на medium, а я не заметил. Представляю, сколько сразу сэкономили на юзерах типа меня. Даже ладошки вспотели, когда увидел (потому что я с ним несколько релизов сделал).

Где же тут хорошая новость? А хорошая — в том, что я почти неделю проработал на medium и этого не заметил. Opus 5.5 — это конкретная машина для убийства, вайбкодит на medium как Opus 4.8 на xhigh, и даже лучше. Как бы то ни было, посмотрите, на каком эффорте кодите вы.

Сейчас меня многие не поймут, простите меня заранее, но я за эту неделю ни разу не открыл Codex, который на тарифе за 200. Я просто не хочу снова ждать. Последние недели с ним были невыносимы. Он всё делает, ничего лишнего, всё аккуратно, но чертовски медленно. Даже /fast режим не ускорял. И когда подвезли турбо-Opus 5.5, я даже и забыл, что у меня еще GPT-6.(1) есть. Не знаю, что с ним делать. Пока что перешёл на тариф за 100, чисто как бэкап, если антропик отсохнет.

Кстати, а зачем теперь нужен Fable и лимиты по нему? :) Хотя, нет, я всё же его юзаю как прагматичного ревью-бади. Отдельно прописал в CLAUDE.md, чтобы запускал ревью с Fable моделью.

365 0 2 11 12


540 0 30 4 12

AppStore вуайерист

Когда я купил себе Apple Dev Certificate, то начал посматривать в топ AppStore на iOS и OS X. Интересно было, какие закономерности и тренды у соло-разработчиков в платных категориях, которые мне понятны и что бы я мог навайбкодить и отправить, чтобы заработать себе на хлебушек. Настроил парсер, накапливаю статистику, чтобы отслеживать динамику, посматриваю время от времени на броуновское движение топов разных категорий. Вот интересные инсайты (по динамике с начала сентября, только соло-разработчики и только платные приложения):

✦ Из 1009 соло-приложений 54% (iOS) не получили ни одной новой оценки за 18 дней. Топ-25 категории ≠ продажи.

✦ 111 разработчиков с ≥2 приложениями в топах — «фабрики» (11 Safari-расширений одного автора, по 7–10 Mac-микроутилит по $0.99, Sindre Sorhus ×5 по $4–24). Мастера слоп-вайбкодинга. Завидую им ))

✦ Developer Tools — самая «соло-дружелюбная» категория (66% приложений — одиночки) потому, что там нет покупателей. Единственный с продажами: Termix Pro (SSH, $9.99, #1 iOS, +8 оценок с 1 сентября)

✦ Utilities — лучший вход для соло. Работающие формы: Safari-расширения (Wipr 2 +21 оценок, Velja +26, Mapper +11, UnTrap +9 — ≥5 независимых разработчиков с реальной динамикой, один код на iOS+macOS), системные микро-утилиты Mac (архиваторы, меню-бар, буфер, диск, OCR), компаньоны для железа (R8 Companion +27, $9.99).

✦ Productivity — 44–48% соло, но спрос у Things/Scrivener. Живые соло-примеры: QuickBend (калькулятор для электриков, #1 iOS, $6.99, +29 — это хит одного человека, не паттерн: 5 из 7 «trade calculators» принадлежат двум разработчикам), Parchment (65 дней, $4.99, 246 оценок, +24, iOS+macOS, #3–4) — единственный свежий соло-запуск с реальной динамикой во всей выборке.

✦ Цена: $4.99 — модальная соло-цена на любом ранге. Компании на macOS в топ-5 берут $11.99, в 6–10 — $16.49; соло — $4.49–4.99. Лидеры по приросту оценок — медиана $5.99, разброс $0.99–$19.99: цена не коррелирует с динамикой.

✦ Форма с доказанным спросом от нескольких независимых авторов: Safari-расширение или Mac-системная утилита, $3.99–4.99, одна кодовая база iOS+macOS. Всё остальное («компаньоны железа», «калькуляторы для профессий») — по 1–2 хита, не паттерн.

Такие дела.


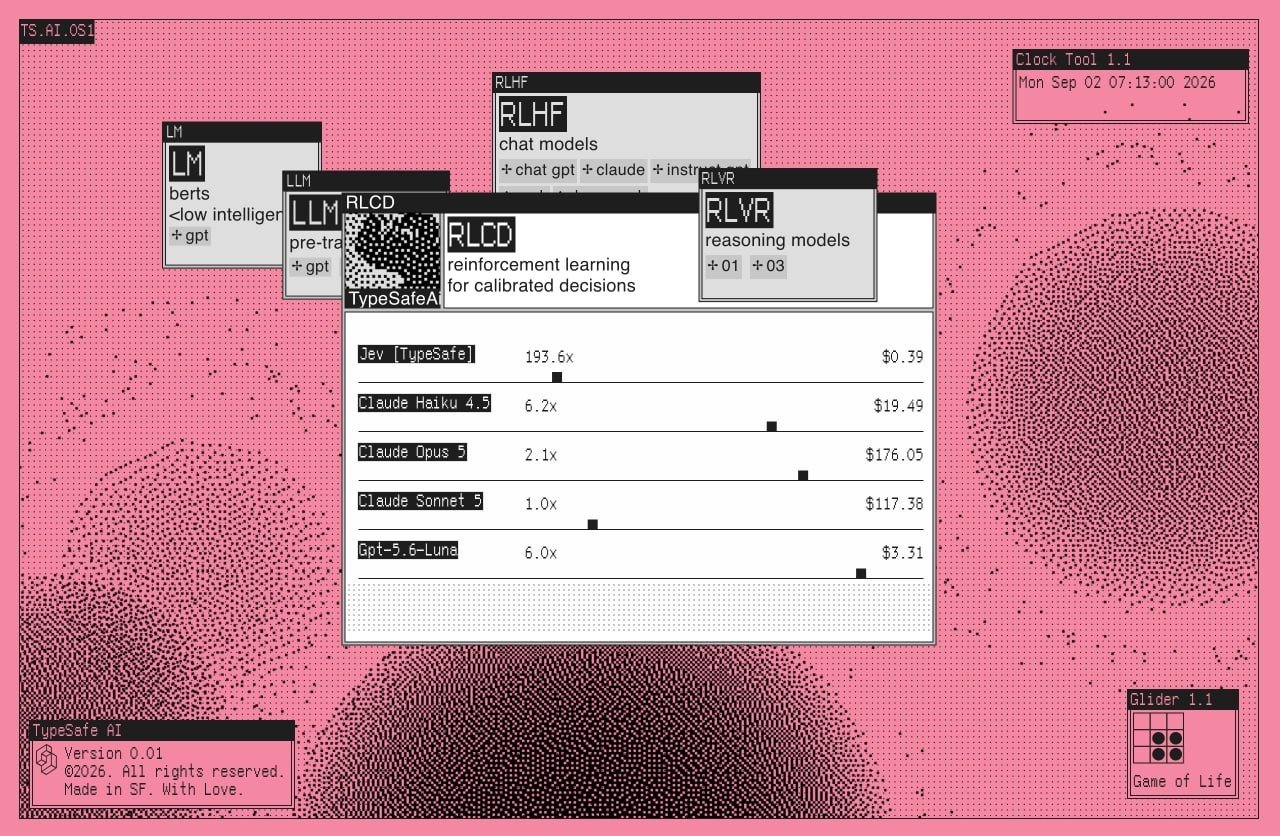
Новый тип моделей: Jev

Тут 15 сентября какие-то ребята с ужасным вкусом (судя по типографике текстов) изобрели новую архитектуру моделей. Я пытался вкурить, чем она принципиально отличается от привычных LLM. И то что я понял — это то, что Jev:

- универсальный 0-shot классификатор (в отличие от BERT может сразу в любую тему и ему не нужно особенно объяснять, с какими классами модель работает);
- умеет в параллель обрабатывать сразу много разных вопросов;
- предназначена для автоматизаций, отвечает в рамках заданных границ и типизированных ответов (или структуры);
- в 190 раз быстрее и в 400 раз дешевле LLM;
- не подходит для случаев, где нужно рассказывать/чатиться/выдавать красивые ответы (для этого они предлагают прицепить к ней обычную LLM)

В общем, вся такая блестящая, светится и переливается красивыми цветами.

Бенчмарков, конечно, нет, и нужно верить джентельменам на слово. Но, если для принятия решения в автоматизации окажется годной, то я за то, чтобы ее заадоптить.

https://typesafe.ai/


"Не зеленое, а круглое"

В современных моделях бесит риторический паттерн ответа "не X, а Y" (протипопоставительное отрицание или "антитеза"). Я вроде спрашиваю у LLM что-то конкретное, про Y, а оно мне всё равно навязывает ещё какой-то факт про X, который, к тому же, оказывается ошибочным и модель сразу "исправляется", и констатирует Y.

"Проблема не в недостатке данных, а в качестве их интерпретации"

"Это не просто инструмент, а новая парадигма"


...и прочий трэш. Я ещё могу смирится с этим в ресерчах и ненаучных отчетах, но когда такое начинает просачиваться в спек на разработку или архитектурный документ — это какой-то зашквар. Особенно много таких фраз в дип-ресерчах Pro моделей OpenAI. Там в каждом абзаце этот эпанортоз ("самооправдание").

Один добрый человек по имени Фредерикко Боггиа уже пробовал разобраться, откуда растут ноги у этой проблемы. Конструкция «не X, а Y» — это очень дешёвый и надёжный способ создать впечатление ясности, нюанса и сильной мысли. Модель выучила её из огромного массива объяснительных, академических, маркетинговых и публицистических текстов, после чего модель отполировали RLHF, которое укоренило и закрепило их в весах, потому что такие ответы, как оказалось, людям-оценщикам часто казались более убедительными и полезными. Короче, во всём виноваты асессоры )

Я запрещаю модели использовать такие конструкции "и вот почему", потому что
1. они упаковывают банальность как уточнение
2. отвлекают
3. тратят токены

Прямо так и пишу в CLAUDE.md / AGENTS.md:
— избегай конструкций вида "не X, а Y", "выводов вида 'и вот почему'...".

Потому что это не только вредно, но и полезно.


Переброс сессий между агентами

У меня закончились лимиты подписки на Codex (и тыква снова превратится в прекрасную карету только через 4 дня), reset'ов мне больше не жалуют, а ещё одну подписку за 200 покупать не очень хочется. Поэтому я снова переключаюсь на Claude Code с Fable 5.1 как основной агент (обычно я его использую для дизайна интерфейсов, всяких рутинных и devops задач).

То, что закончились лимиты — такое у меня не в первый раз. И часто оно происходит в самый неподходящий момент, где-то посередине сессии, которая уже работала часов 5. Поэтому, чтобы не терять работу Codex, я делаю переброс сессии в Claude. Когда у Codex остается от подписки 2-3%, я его останавливаю и прошу написать handoff документ по передаче дел другому разработчику в рамках этой сессии. Он сам знает, что сделано, что осталось, где какие проблемы обнаружены. Обычно Codex пишет документ килобайт на 18 и обозначает план дальнейших действий и критерии завершения задачи. После чего я закрываю Codex и отправляю его на пенсию, открываю в том же каталоге Claude Code, закидываю в него этот документ и говорю "Scrutinize the handoff document and resume execution of the task". Как правило, Claude нормально подбирает задачу и заканчивает её раза в три быстрее (но не всегда с таким же качественным кодом, к сожалению).

Так что, когда становится очевидно, что в рамках лимитов сессию не закончить, а очень надо — главное, не вафлить, и во-время остановить агента, чтобы он написал handoff (или handover) документ. Думаю, на это можно даже какой-то хук повесить. Но я пока что делаю это ручками. А если, вдруг, опоздал и не сделал, то просто скармливаю сессию Codex в Claude и говорю:
— разберись, что там была за задача, что уже сделано и что осталось. И продолжи с того же места до завершения.


Работа на сегодня завершена. Пошёл трогать траву.


Длинные сессии и рекурсия бэклога сессии

У меня сейчас есть сессия, которая работает третий день, и это проблема. Исходная задача включала в себя рефакторинг большого куска проекта. Я стартовал сессию с тщательно проверенного спека на изменения и списка задач. Сам рефакторинг был выполнен за несколько часов, но потом начался длинный хвост тестирования и фиксов, который всё ещё выполняется: агент залип в непрогнозируемом цикле "тестируем → находим ошибки → делаем триаж → фиксим → снова тестируем → находим ошибки → делаем триаж ..." и так пару дней уже.

Первый день я читал вердикты, смотрел сами баги, и всё было по-делу, поэтому я не вмешивался. На второй день я начал терять связь с процессом и терпение, и начал задавать вопросы: "почему исправляется вот это", "какие оценки по завершению всей задачи", и т.п. Оценки у агента такие же, как у любого программиста: всегда "82% уже готово, осталось совсем чуть-чуть."

В какой-то момент я понял, что надо начинать микроменеджить: запромптил в сессию параллелизацию, приоритизацию в выполнении, вроде пошло побыстрее. Но сегодня — третий день, а "воз и ныне там". Я не могу сказать, что делается ерунда. Он находит реальные баги. Но и PR'а с готовым мёржем тоже нет, есть штук 70 коммитов.

Короче, агенты научились работать долго и автономно, но пока ещё не могут деливерить как люди, отфильтровывая неважное и "срезая углы".

Мне очень не хватает инструмента визуализации бэклога сессии и прогресса. Когда ты смотришь на 10,000 строк консольной (или UI) истории чата, в ней сложно понять, в каком месте находится агент с текущей задачей, сколько осталось, какие новые задачи появились в процессе работы, что это за задач, какой у них был выбран приоритет и т.п.

И я подумал, что было бы неплохо иметь что-то типа временной "борды" (например, в формате kanban), которая бы отражала состояние текущей сессии. Например, я скормил в агента большой спек, в нём, условно, 40 задач. Они все попадают в TODO, потом начинают двигаться до DONE по стейтам. Когда ничего нового не появляется — то достаточно иметь чеклист и смотреть завершенные пункты в нём (я раньше просто просил отмечать [x] прямо в документе). Но когда начинается параллелизация, декомпозиция и обнаруживаются баги в имплементации, вскрываются регрессии и новые баги в старом коде, то в бэклоге сессии появляется пачка новых задач, и этот условный бэклог сессии начинает колоссально разрастаться, и простого чеклиста здесь уже не хватает.

Можно было бы просить агента работать только через глобальные таски: при обнаружении проблем заводить задачи, потом отдельно проводить сессию триажа, и после этого только брать задачу в работу, и там же обновлять её статус. Но я так разок уже пробовал, и это работало очень медленно + добавляло кучу накладных расходов [токенов] на анализ и передвижение задач по статусам, добавление комментариев в них и т.п. Как будто бы такой процесс увеличивает drift агента от его основной задачи. Поэтому у меня мысль, скорее, про какую-то временную disposable "доску", которую можно было бы прицепить как скилл и говорить агенту её обновлять в определенных контрольных точках.

Если у вас есть большой проект с длинными сессиями, вы, наверняка, сталкивались с подобными проблемами. Как решали/решаете?


Домашний сетап, когда из старых макбуков пытаешься сделать воркеры для CI/CD пайплайнов


playwright-cli vs agent-browser: кто выигрывает и когда

В рамках регулярной активности "надо бы посмотреть, что там нового вышло из сферы AI" посмотрел, какие есть альтернативы моему любимому playwright-cli для автоматизации работы внутри браузера (вообще не представляю, как без него можно жить в 2026-м). Поискал, и нашёл agent-browser, как достойную альтернативу.

Сначала мне показалось, что agent-browser — это мой новый фаворит (потому что у него один бинарник 7MB, а вся остальная обвязка — вокруг Chrome как у playwright). Прогнал оба на одинаковых задачах: один сайт, одни и те же 100 записей, каждый сценарий — с холодного старта.

agent-browser быстрее стартует. Нативный бинарь поднимается за 0.64 с против 0.93 с у Node-демона playwright-cli (по сети — 1.22 против 2.05). Поэтому он забирает все короткие задачи: текст страницы, скриншот — agent-browser в полтора раза быстрее.

Но playwright-cli в целом работает быстрее. На страницу он тратит 0.052 с против 0.087 с. Фора agent-browser в старте отыгрывается при числе страниц скрейпинга больше 15. Дальше отрыв растёт: на 1000 страниц — 53 с против 88 с.

А ещё playwright-cli легче по памяти — во всех 14 замерах в среднем мегабайт на 200. Парадокс: его Node-демон занимает 159 МБ против 7 МБ у нативного бинарника agent-browser, но agent-browser держит Chrome при DPR 2 с пятью рендерерами вместо трёх, и GPU-процесс съедает разницу с запасом.

Что и когда использовать:
— одна короткая задача, браузер каждый раз новый → agent-browser
— пакет известных URL одним вызовом → agent-browser (batch, 1.6–2.7×)
— много страниц в одной сессии → playwright-cli
— мало памяти на машине → playwright-cli
— генерация тестов, trace, video → playwright-cli

Выигрыши playwright-cli масштабируются с объёмом. Поэтому для регулярной работы я бы держал по умолчанию playwright-cli, а agent-browser доставал под одноразовые задачи и batch. Сами сценарии использования и механизмы управления сессиями одинаковые. Я запускаю оба через скиллы с указанием конкретного профиля и сессии: один раз залогинился в кучу сайтов и могу из агента командовать "Посмотри-ка на сайте налоговой, нет ли там каких уведомлений" или "Сходи-ка на Hostinger и заведи новую виртуалку".

Еще вчера выяснил, что у playwright-cli каждый eval / run script забирает 1 секунду времени, поэтому при сложных сценариях анализа страницы теряются секунды на каждый такой обработчик. Оптимизировал скилл, чтобы он использовал другие механизмы, теперь работает в 10 раз быстрее.

Мой оптимизированный скилл для playwright-cli можно забрать здесь.
А здесь я выложил скилл agent-browser.

И, конечно, ничто так не мотивирует вести блог и выкладывать свои наработки, как реакции под постом, и "звёздочки" в репе. ;)

Мяу.

504 0 37 11 14


Профессиональный профиль и контекст

Проделал сегодня интересное упражнение: натравил Claude [Fable] на свои 85 проектов и попросил составить мой профиль: экспертизу, опыт, интересы, слабые стороны и вывести его в структурном виде. Также попросил включить в него анализ софт- и хард-скиллов, и т.п. Суммарный документ содержит:

1. Executive snapshot — the distinctive 5-way combination and scale of evidence
2. 8 domains of demonstrated expertise — AI/LLM engineering, security, native Apple, backend/infra, product/commercial, audio/music, technical writing & research, teaching/family engineering — each grounded in specific code and docs
3. Hard skills matrix — languages, AI/ML, backend/data/infra, frontend, security, product/business, with proficiency levels inferred from depth/breadth/recency plus the evidence for each
4. Soft skills — evidenced rather than asserted (systems thinking, doc discipline, intellectual honesty, self-governance, learning velocity, autonomy/finish)
5. 10 signature engineering practices — the repeating patterns that constitute a personal methodology
6. Positioning statements — ready-to-use framings
7. Honest gaps — added proactively; a flattering-only profile isn't useful
8. Project reference index — categorized tables with stack per project, * for deployed/distributed

Для чего можно будет дальше использовать данный профиль? Вариантов масса. Например, можно прокачать себе слабые стороны в области своих интересов. Кто ищет работу — можно быстро составить хорошо структурированную карточку в LinkedIn или просто искать работу среди того, что ближе всего или лучше всего получается. Можно идеи для бизнеса искать, которые вероятнее всего сможешь сделать как инди-разработчик/соло-фаундер.

Я вообще склоняюсь к тому, что нужно заводить о себе отдельные профили (контексты): профессиональный, по здоровью, по интересам и предпочтениям. А дальше просто закидываешь готовый документ на 800 строк о себе в агента и просишь что-то подобрать для себя. Например, если есть нормальный документ с описанием предпочтений про формат/места отдыха, можно зарядить поиск по тому, куда поехать и т.п. Аналогично — с одеждой, едой, фильмами и т.п. Ну, это всё "капитанство", вы это и так знаете.

Я пока не придумал, как организовать контекст о себе в единую связанную и регулярно обновляемую базу. Кроме, разве что, очевидных маркдаунов внутри обсидиана (но я не люблю ни обсидиан, ни какие-то кастомные "памяти"). Тем не менее, если будут просто документы в маркдауне, загрузить их потом в какое-то индексное и структурированное хранилище — не проблема. Короче, чем больше пользуюсь агентами для решения рабочих и бытовых вопросов, тем больше понимаю, что уже пора начинать формировать контекст о себе и поддерживать его регулярно.


Персональные AI агенты. Где они?

Помните, были такие OpenClaw и Hermes? Люди ещё массово скупали под них мак мини. Хайп как бы прошёл.

Вот там где пик — мы с коллегой начали делать продукт, который обеспечивал слой безопасности для ai агентов (чтобы агент не мог ключики/токены/конфиги сервера отправить злоумышленнику или сделать опасные операции на серваке). https://imunify.ai.

Но для того, чтобы был спрос на этот продукт, нужно, чтобы сначала был спрос на сами персональные ai агенты. А тренд, как видно, нисходящий.

Такая вот правда продуктовой разработки в 2026 году. Если не успел напродавать в первые пару месяцев хайпа, можешь уже ничего не успеть продать.


Video oldindan ko‘rish uchun mavjud emas
Telegram'da ko‘rish
Танчики в Roblox

Долго сопротивлялся, но в итоге сел вчера с ребенком и сделал игру для платформы Roblox. За пару часов получилось разобраться в том, что такое Roblox в принципе (потому что я вообще мимо всей этой темы), сделать игру про танчики и опубликовать её.

Теперь дело за малым: заработать миллиард робаксов нужно набрать 500 сыгранных партий от других пользователей, чтобы получить статус Age 9+, потому что изначально игра публикуется с рейтингом 16+ и не видна моей маленькой ЦА :-).

Писал всё Fable 5: сам звуки нашёл, нарисовал спрайты и т.п. Я только предварительно создал пару скиллов (чтобы он знал как создавать заготовку игры, как работать с rojo сервисом).

Интегрировал с Roblox Studio через roblox-rojo: очень удобно, когда Fable тебе пилит lua скрипты, а ты просто жмёшь кнопку Play и тестируешь. Наверное, есть способ лучше, но за пару часов я не разобрался. Был ещё вариант с MCP, но он менее функциональный.

В общем, если кто-то (вдруг) в свои 40 лет играет в Roblox, милости прошу. Мой личный рекорд: 7 уровень, 15630 поинтов.

https://www.roblox.com/games/94549316817840/Baby-Tanks


Типовые косяки агентов (август 2026)

У меня есть сложный проект, в котором 99% кода написано AI (код уровня подсистем ядра Linux и секурити: eBPF LSM, TPROXY, fanotify). На нём отлично видно, как кодинговые агенты лажают.

Наиболее типичные ошибки, которые я замечаю:

- Автоматические тесты через агента тестируют не реальные сценарии. Например, у юзера стартует один сервис, а в плейбуке в момент тестирования создается другой сервис. После чего, какие-то сценарии начинают валиться с ошибками и агент маркирует это как "Critical", заводит задачу "на серьезных щах" и даже порывается пофиксить.
- Агенты переусложняют реализацию. Если дать им полную свободу продуктового мышления, то они навертят кучу сложностей, которые вообще не нужны (или не нужны в ближайшие пару лет точно)
- Агенты всегда находят ошибки в ревью кода. То есть можно запускать на сложной кодовой базе ревьюер, потом фиксить его находки, запускать ещё раз, фиксить... и каждый раз получать новую порцию "проблем". После ревью агент обычно ещё делает триаж найденных задач, и часть из них становится Critical/Major ошибочно. Потому что если разбираться в продукте и его архитектуре, там из 23 найденных проблем, ну, может, три Major, остальные — можно смело засунуть в бэклог и никогда до них не дойти.
- Сложные планы агенты реализуют неэффективно. Ну то есть человек смотрит на объем работ из плана и начинает отмечать кластеры работы, группировать изменения, делать сначала code complete, точечно проверять в реальных сценариях на реальных сервера, а потом уже тестить всё полными e2e. Агент (без специальных инструкций) послушно выполняет план и постоянно сползает в сторону "после каждого изменения запустить тесты".

Сначала я думал, что проблема в моём харнессе вокруг проекта, но потом у меня появилось ещё три других проекта, где всё было совсем по-другому, а проблемы те же.

Противоядие от этих проблем есть. Нужно понимать проект (как с технической, так и с продуктовой стороны). И иногда проваливаться очень глубоко в реализацию (когда начинается очевидный булщит вместо фикса кода). Это раздражает, но пока по-другому никак.

Если что, у меня gpt-5.6-sol xhigh и Fable 5 xhigh. Другие модели работают ещё хуже (отдельная подстава с Opus 5 на который иногда делает авто-фолбэк Fable 5).

—

Если у вас нет таких проблем, скорее всего проект не сильно сложный. Ну или вы — чертов гений! Хочу с вами познакомиться, чтобы вы меня научили.

20 ta oxirgi post ko‘rsatilgan.